I. Resumen del Evento
El 24 de abril de 2026, DeepSeek lanzó oficialmente la versión preliminar de los modelos grandes de la serie V4, incluyendo el buque insignia DeepSeek-V4-Pro (1,6 billones de parámetros totales / 49 mil millones de parámetros activados) y el modelo ligero DeepSeek-V4-Flash (284 mil millones de parámetros totales / 13 mil millones de parámetros activados). Ambos admiten de forma nativa una ventana de contexto de 1 millón de tokens y son completamente de código abierto bajo la licencia MIT. La serie V4 estuvo disponible formalmente el 20 de julio, y la versión oficial V4-Flash-0731 API se lanzó para pruebas públicas el 31 de julio.
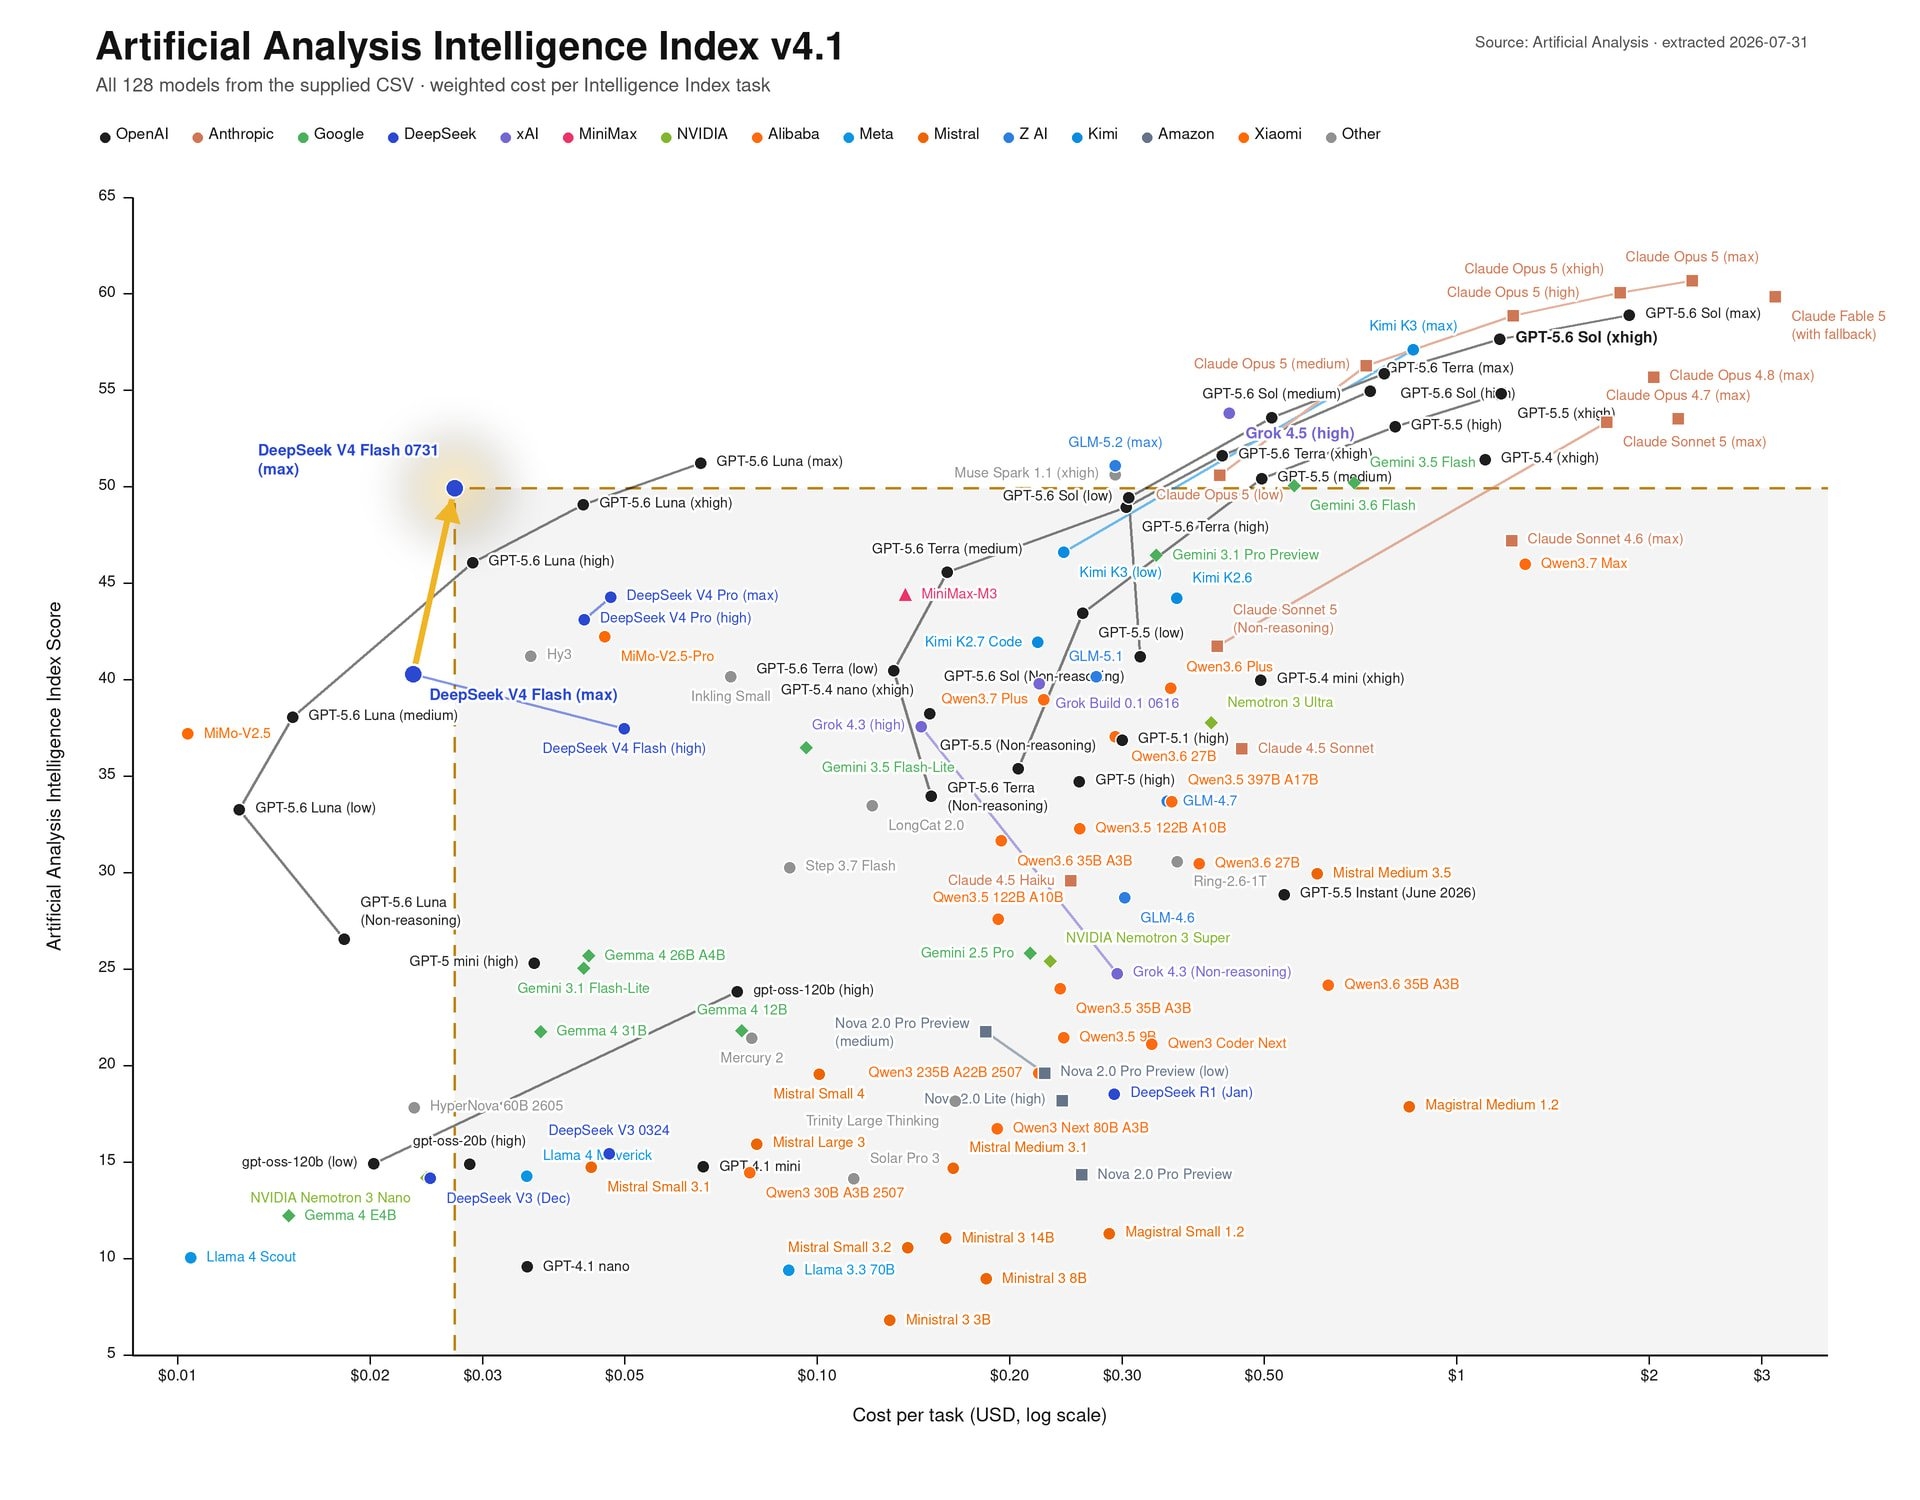
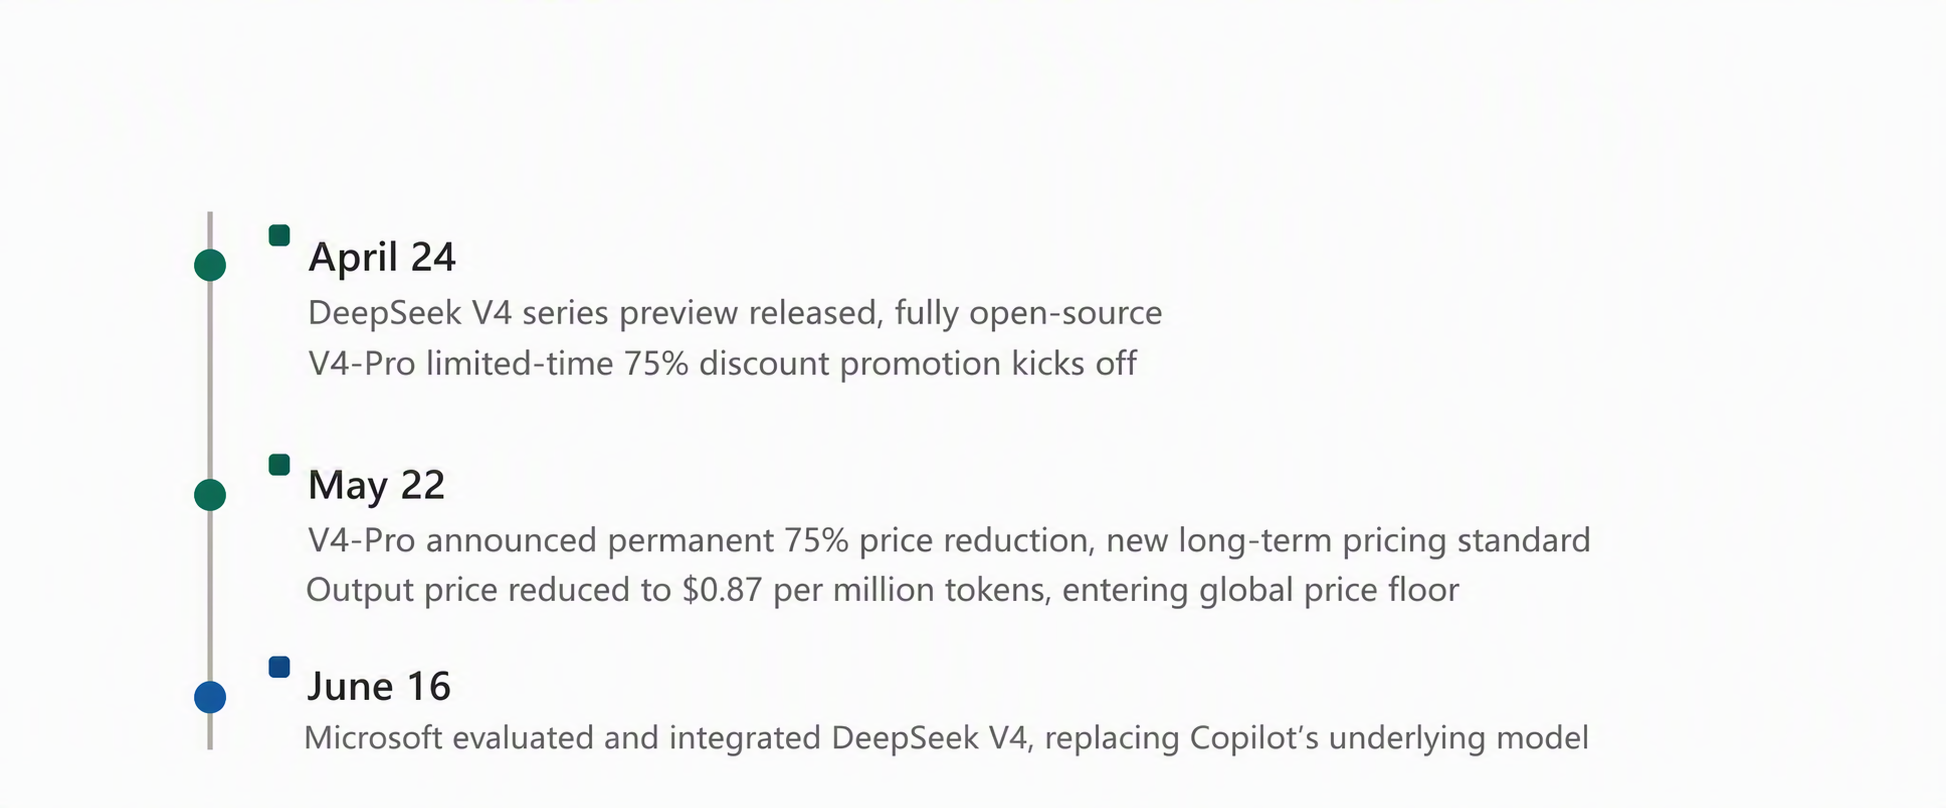
El mismo día, DeepSeek anunció una reducción permanente del 75 % en el precio de la API de V4-Pro. En escenarios de acierto de caché, el precio de entrada cayó hasta 0,025 yuanes por millón de tokens, con la salida a 6 yuanes por millón de tokens: un nuevo precio mínimo entre los modelos de vanguardia mundiales.
II. Avances Tecnológicos: No se trata solo de ser barato
La serie V4 introdujo tres tecnologías centrales:
- Arquitectura de Atención Híbrida (CSA + HCA) : Combina atención dispersa comprimida con atención altamente comprimida. Con un contexto de 1 millón de tokens, el cómputo de inferencia es solo el 27 % del de V3.2, y la caché KV utiliza solo el 10 %.
- Hiperconexión con Restricción de Variedad (mHC) : Sustituye las conexiones residuales tradicionales, garantizando la estabilidad del entrenamiento en redes de decenas de miles de capas.
- Entrenamiento e Inferencia de Precisión Mixta FP4/FP8 : Primera implementación en la industria. Reduce la presión sobre el ancho de banda de la VRAM en un 50 % y duplica la eficiencia de inferencia.
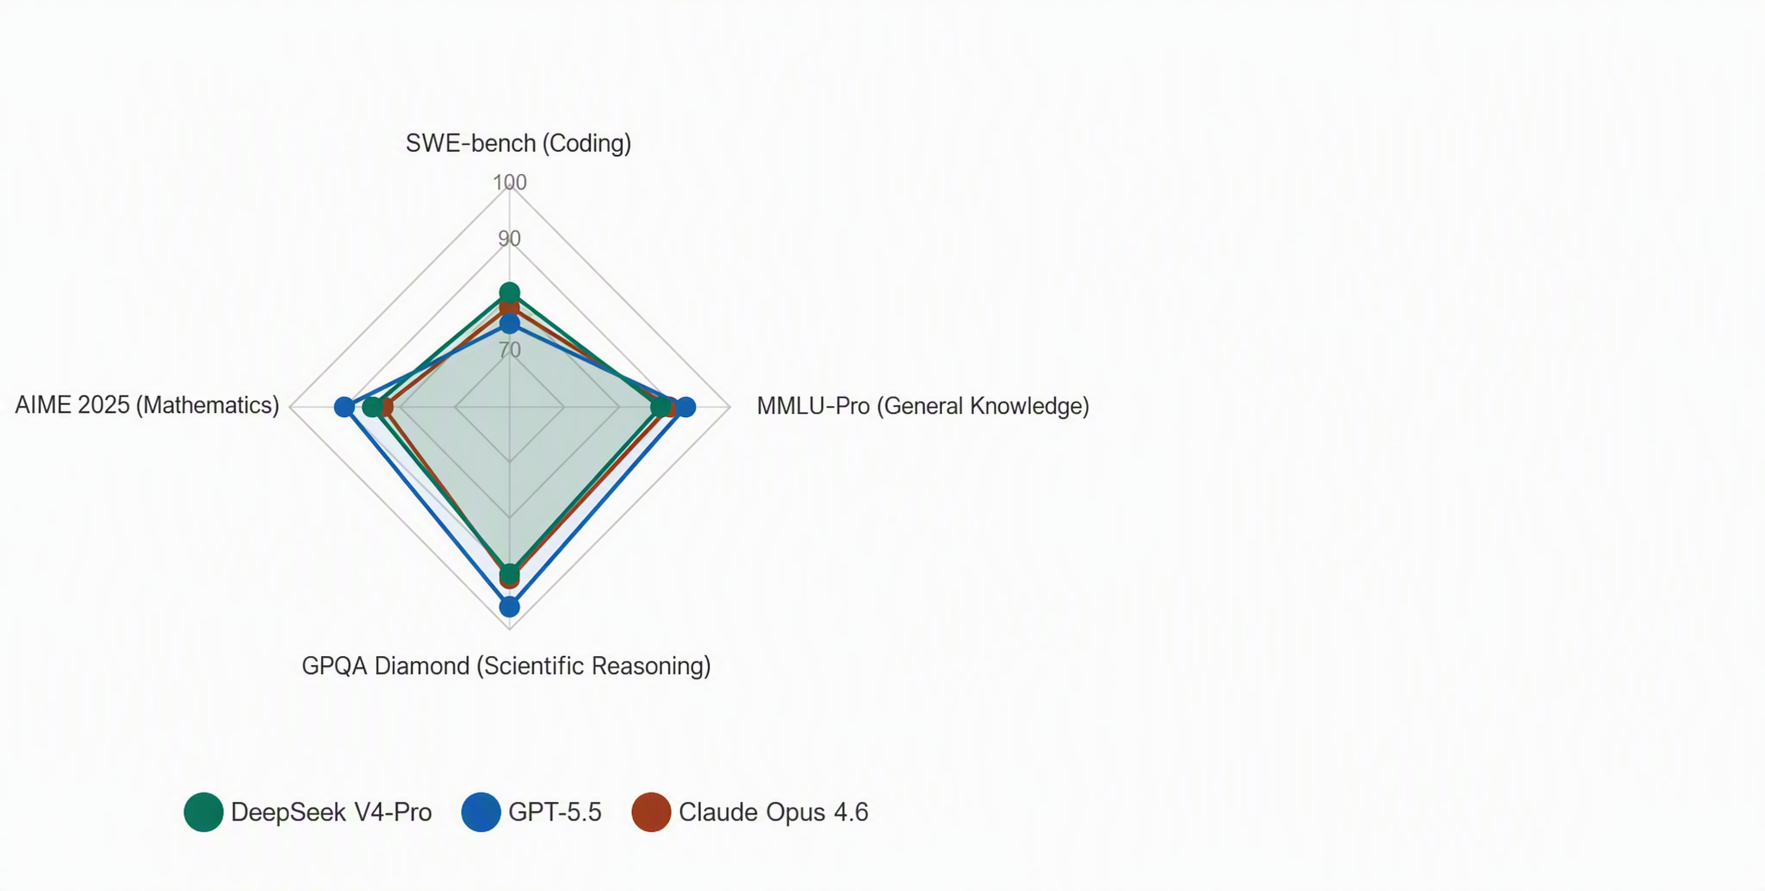
En SWE-bench Verified (capacidad de codificación), V4-Pro obtuvo un 80,6 %, liderando todos los modelos de código abierto y casi igualando el 80,8 % de Claude Opus 4.6. Obtuvo un 87,5 % en MMLU-Pro y un 85,0 % en razonamiento matemático AIME 2025. En su informe técnico, DeepSeek admitió estar “ligeramente por detrás de GPT-5.4 y Gemini-3.1-Pro entre 3 y 6 meses”, pero considerando la diferencia de precio, esto es casi irrelevante.
III. Masacre de Precios: La “Línea de Ejecución” para los Modelos Grandes Mundiales
Los precios de V4-Pro destrozaron directamente el sistema de precios de los modelos grandes a nivel mundial. A continuación se muestra una comparación de los precios de salida de los principales modelos en julio de 2026 (en dólares estadounidenses por millón de tokens):
Gráfico 1: Comparación de precios de salida de API de los principales modelos en julio de 2026 (escala logarítmica)
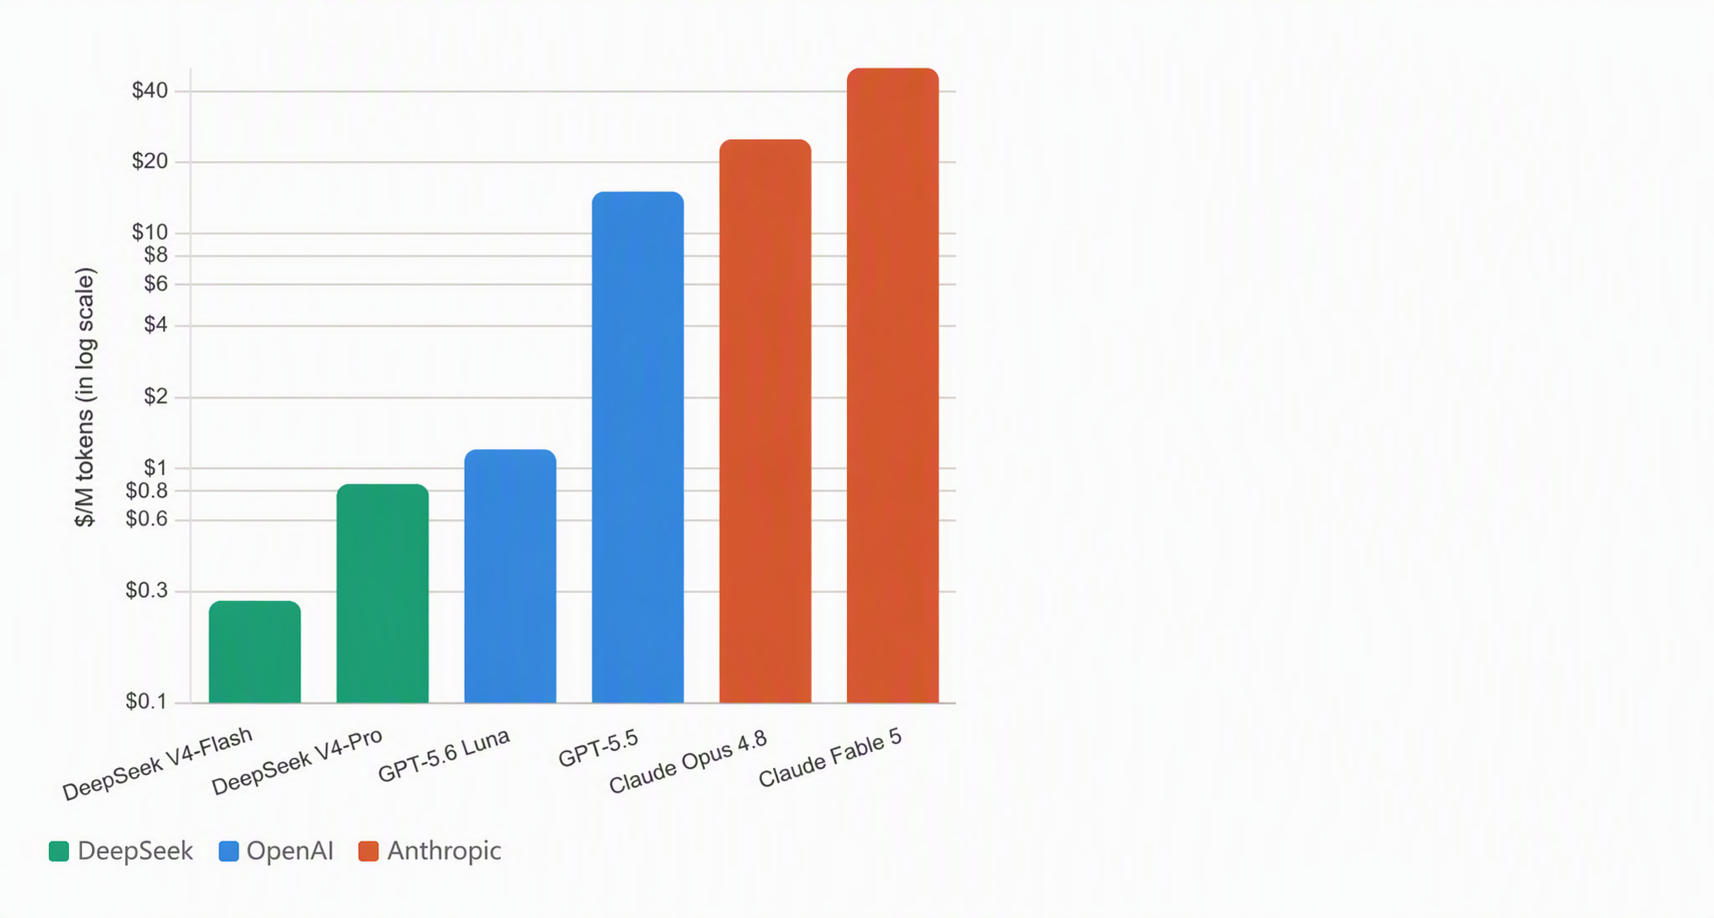
La comunidad de desarrolladores fuera de China ha llegado a un consenso: Para la gran mayoría de escenarios C-end y B-end pequeños y medianos, incurrir en costos de inferencia decenas de veces superiores por mejoras marginales de rendimiento no tiene viabilidad comercial. Para cualquier competidor con un precio superior al de DeepSeek, solo quedan dos caminos: recortar los precios de forma proactiva y significativa, o abandonar por completo el mercado masivo de desarrolladores.
Gráfico 2: Comparación de benchmarks principales (gráfico de radar)
IV. Impacto en los principales modelos
4.1 OpenAI: de la arrogancia a los recortes urgentes de precios
OpenAI fue la más afectada directamente. En 2025, sus ingresos anuales fueron de 13.000 millones de dólares, el gasto total de 34.000 millones y la pérdida neta de 39.000 millones, de los cuales unos 8.000 millones fueron pérdidas operativas.
El 30 de julio de 2026, apenas tres semanas después del lanzamiento de GPT-5.6, OpenAI anunció urgentemente una reducción de precio del 80 % para la versión Luna. El CEO Sam Altman reconoció públicamente que el costo es el "mayor desafío de la industria" y afirmó que "OpenAI está feliz de recortar los precios un 75 %", lo que los observadores interpretaron como una respuesta pasiva a DeepSeek.
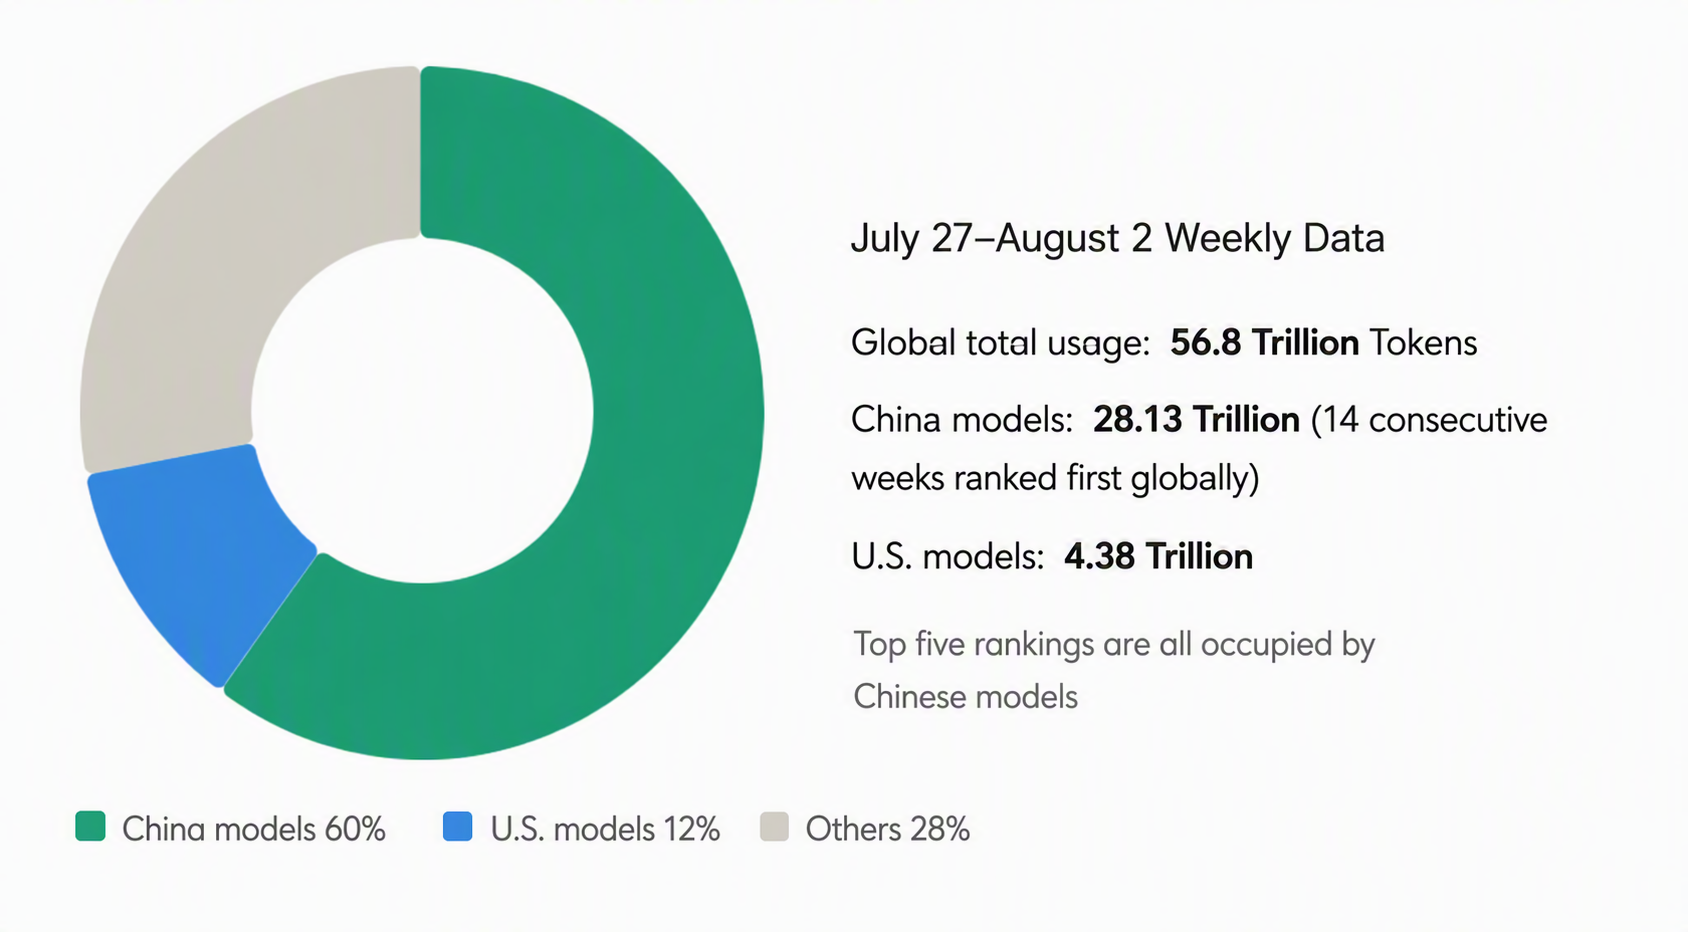
En la plataforma OpenRouter, el consumo semanal de tokens por parte de los modelos chinos ha superado el 60 %, mientras que el de los modelos estadounidenses ha caído por debajo del 20 % [9]. Los datos de la plataforma en la nube estadounidense Vercel muestran que la cuota de uso de los modelos DeepSeek en el mercado empresarial se disparó del 1 % en abril al 17 % en mayo.
4.2 Anthropic: la estrategia de precios altos bajo presión
Claude Fable 5 tiene un precio de 50 dólares por millón de tokens de salida, 57 veces mayor que el de V4-Pro. En junio de 2026, Anthropic comenzó a prohibir el uso de Claude a usuarios fuera de China, reduciendo proactivamente su mercado, lo que se interpretó como una medida forzada por los costos de cómputo excesivamente altos para centrarse en mercados de alto ARPU.
4.3 Google: escasez de potencia de cómputo
Los pedidos pendientes de Google Cloud han alcanzado los 460.000 millones de dólares, y Gemini ha comenzado a implementar cuotas de uso para clientes importantes como Meta.
4.4 Microsoft: señales de deserción
El 16 de junio de 2026, Microsoft comenzó oficialmente a evaluar la integración de DeepSeek V4 en Copilot Cowork para reemplazar los modelos de OpenAI y Anthropic. El CEO Satya Nadella declaró públicamente: "Modelos más baratos y opciones más amplias aumentarán la confianza de la sociedad en la IA; el público no tolerará que unos pocos modelos y empresas monopolicen todo el aprendizaje". Dada la participación accionaria del 27 % de Microsoft en OpenAI, esta declaración sacudió a la industria.
4.5 Nvidia: resquebrajamiento del foso de CUDA
El día del lanzamiento de DeepSeek V4, logró una adaptación completa en ocho grandes productores de GPU chinos: Huawei Ascend, Cambricon, Hygon, Moore Threads, Muxi, Kunlun Core, Alibaba T-Head y Tianjic. Bernstein predice que la cuota de Nvidia en el mercado de aceleradores de IA en China caerá del 95 % a alrededor del 8 % en 2026, mientras que la de Huawei Ascend aumentará al 50 %–62 %.
Gráfico 3: cronología de eventos clave de la guerra de precios de grandes modelos de 2026
V. Frenesí de capital: valoración de 500.000 millones
En junio de 2026: DeepSeek completó la primera ronda de financiación externa que superó los 50.000 millones de yuanes, con una valoración superior a los 50.000 millones de dólares. Los inversores incluyeron a Liang Wenfeng, que aportó personalmente 20.000 millones de yuanes, Tencent con 10.000 millones, CATL con 5.000 millones, JD.com con 3.000 millones y el Fondo Nacional de Inversión en la Industria de la IA.
Agosto de 2026: Lanzó una segunda ronda de financiación de 50.000 millones de yuanes, con una valoración pre-money de unos 500.000 millones de yuanes (alrededor de 74.000 millones de dólares).
La valoración total de los cuatro principales laboratorios de IA pura de China ha alcanzado unos 159.000 millones de dólares, frente a casi cero hace 18 meses.
VI. Datos de mercado: los modelos chinos dominan los rankings globales de uso
Gráfico 4: cuota global de llamadas de tokens en la plataforma OpenRouter (27 de julio – 2 de agosto)
VII. Reversiones y preocupaciones
7.1 Escasez de potencia de cómputo, precios a punto de aumentar
El 6 de agosto, DeepSeek anunció que estaba a punto de "aumentar significativamente los precios de API". Su potencia de cómputo actual equivale a solo unas 20.000 GPU H100, muy por detrás de competidores estadounidenses como OpenAI.
7.2 Riesgos políticos
El gobierno de EE. UU. está muy alerta ante la posible entrada de los modelos de DeepSeek en la infraestructura empresarial estadounidense. Incluso desplegados en los centros de datos de Azure de Microsoft en EE. UU., todavía se enfrentan a revisiones de seguridad.
7.3 Paradoja de la comercialización
El ratio precio-ventas (P/S) del V4-Pro superó las 3.800 veces, decenas de veces el de Anthropic, pero sus ingresos anualizados son extremadamente bajos. La lógica de precios de Liang Wenfeng era que "recuperar el costo del servidor en 10 meses se considera un beneficio razonable", y los inversores se enfrentan al riesgo de una inversión de la valoración.
VIII. Comentario de SMM
SMM comentó al respecto. En primer lugar, el punto de referencia global de precios de grandes modelos ha pasado del entendimiento tácito entre los tres oligarcas de Silicon Valley a la "línea letal" definida por DeepSeek. Mientras tanto, la ruta de eficiencia extrema de MoE + atención dispersa + precisión mixta demuestra que el rendimiento de vanguardia no tiene que depender de acumular potencia de cómputo. En el lado del ecosistema, los chips nacionales como Huawei Ascend han ganado oportunidades prácticas a gran escala, y la barrera de CUDA se está resquebrajando, Es posible que el final de la competencia global de grandes modelos no lo gane el modelo más potente, ni el más barato, sino la solución óptima en la curva de costo-rendimiento "capacidad/coste", que será el ganador final.
Referencias
- DeepSeek V4 Pro llega con contexto de 1 millón de tokens, remodelando nuestro cálculo de costes — —
- AI Wiki —
- DeepSeek se convierte en la línea letal global de la IA —
- DeepSeek-V4-Pro: el modelo de código abierto que está reescribiendo las reglas de la IA —
- DeepSeek y Zhipu rompen el bloqueo de la potencia de cómputo: el modelo Zhipu entra en el top tres, DeepSeek reduce el costo a 1/20 —
- Cómo DeepSeek y Alibaba están derribando las barreras de precios de la IA: una diferencia de costos de 70 veces está remodelando el panorama de la industria global —
- Tras el lanzamiento oficial de DeepSeek-V4-Flash, los principales productores de modelos, como OpenAI, redujeron los precios —
- Explicación de la guerra de precios de inferencia de IA —
- El costo de inferencia de DeepSeek cae a 1/36 del de GPT-4o, ¿cómo reescribirá las reglas de la industria? —
- La infraestructura de IA se ha convertido en el tipo de negocio que Munger más odia —
- Microsoft evalúa usar el modelo DeepSeek V4 para reducir costos y aumentar la eficiencia, reemplazando potencialmente a OpenAI y Anthropic —
- Guerra de precios de IA 2026: por qué el verdadero ganador no es DeepSeek ni OpenAI —
- Google raciona Gemini para Meta: cuando la computación se convierte en el recurso más escaso —
- Microsoft apunta a DeepSeek V4 para Copilot Cowork: lo que el alojamiento de Azure no puede solucionar —
- Auge de los chips nacionales: ha llegado lo que más teme Nvidia —
- La gran migración de la potencia de cómputo de IA: 2026, tres cambios simultáneos —
- DeepSeek recauda 7.400 millones de dólares con una valoración de 50.000 millones en la primera ronda de financiación externa —
- Informes: DeepSeek ha reiniciado una segunda ronda de financiación de 50.000 millones de yuanes —
- Valoración de hasta 500.000 millones de yuanes, DeepSeek encabeza los rankings globales de llamadas a grandes modelos —
- ¡Se acabaron los precios bajos! DeepSeek se dispone a subir los precios significativamente —
- ¿Cuáles son las perspectivas de desarrollo futuro de DeepSeek? —